Генеральная совокупность и выборочное исследование. Статистическая достоверность
Статистика давно уже стала неотъемлемой частью жизни. С ней люди сталкиваются всюду. На основе статистики делаются выводы о том, где и какие заболевания распространены, что более востребовано в конкретном регионе или среди определенного слоя населения. На основываются даже построения политических программ кандидатов в органы власти. Ими же пользуются и торговые сети при закупке товаров, а производители руководствуются этими данными в своих предложениях.
Статистика играет важную роль в жизни общества и влияет на каждого его отдельного члена даже в мелочах. Например, если по , большинство людей предпочитают темные цвета в одежде в конкретном городе или регионе, то найти яркий желтый плащ с цветочным принтом в местных торговых точках будет крайне затруднительно. Но из каких величин складываются эти данные, оказывающие такое влияние? К примеру, что представляет собой «статистическая значимость»? Что именно понимается под этим определением?
Что это?
Статистика как наука складывается из сочетания разных величин и понятий. Одним из них и является понятие «статистическая значимость». Так называется значение переменных величин, вероятность появления других показателей в которых ничтожно мала.
К примеру, 9 из 10 человек надевают на ноги резиновую обувь во время утренней прогулки за грибами в осенний лес после дождливой ночи. Вероятность того что в какой-то момент 8 из них обуются в парусиновые мокасины - ничтожно мала. Таким образом, в данном конкретном примере число 9 является величиной, которая и называется «статистическая значимость».
Соответственно, если развивать далее приведенный практический пример, обувные магазины закупают к концу летнего сезона резиновые сапожки в большом количестве, чем в другое время года. Так, величина статистического значения оказывает влияние на обычную жизнь.
Разумеется, в сложных подсчетах, допустим, при прогнозе распространения вирусов, учитывается большое число переменных. Но сама суть определения значимого показателя статистических данных - аналогична, вне зависимости от сложности подсчетов и количества непостоянных величин.
Как вычисляют?
Используются при вычислении значения показателя «статистическая значимость» уравнения. То есть можно утверждать, что в этом случае все решает математика. Самым простым вариантом вычисления является цепь математических действий, в которой участвуют следующие параметры:
- два типа результатов, полученных при опросах или изучении объективных данных, к примеру, сумм на которые совершаются покупки, обозначаемые а и b;
- показатель для обеих групп - n;
- значение доли объединенной выборки - p;
- понятие «стандартная ошибка» - SE.
Следующим этапом определяется общий тестовый показатель - t, его значение сравнивается с числом 1,96. 1,96 - это усредненное значение, передающее диапазон в 95 %, согласно функции t-распределения Стьюдента.
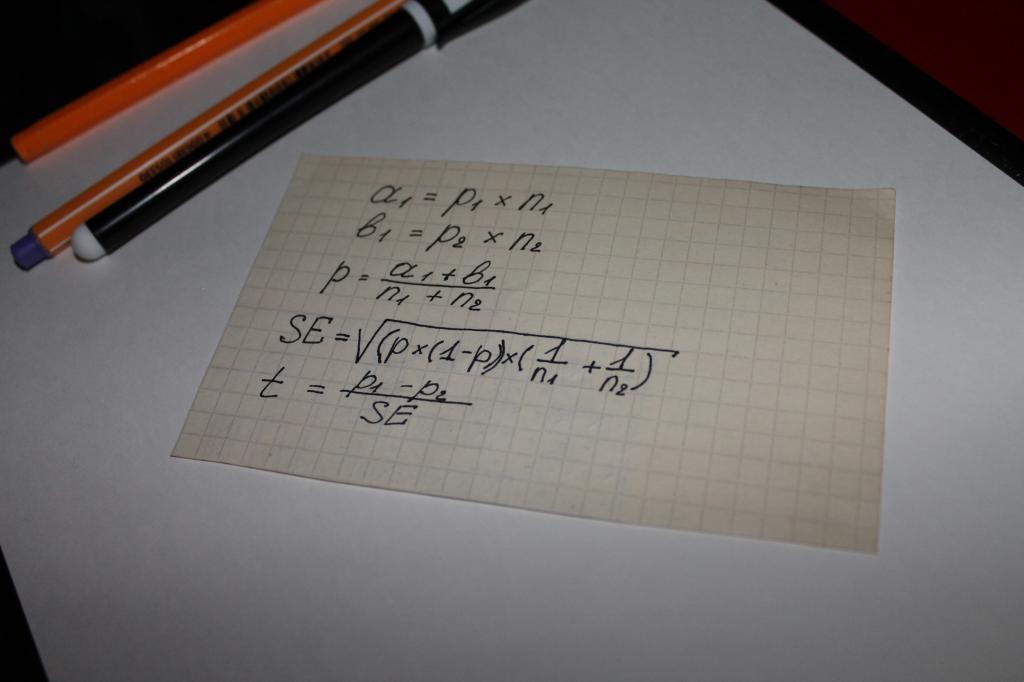
Часто возникает вопрос о том, в чем отличие значений n и p. Этот нюанс просто прояснить при помощи примера. Допустим, вычисляется статистическая значимость лояльности к какому-либо товару или бренду мужчин и женщин.
В этом случае за буквенными обозначениями будет стоять следующее:
- n - число опрошенных;
- p - число довольных продуктом.
Численность опрошенных женщин в этом случае будет обозначено, как n1. Соответственно, мужчин - n2. То же значение будут иметь цифры «1» и «2» у символа p.
Сравнение тестового показателя с усредненными значениями расчетных таблиц Стьюдента и становится тем, что называется «статистическая значимость».
Что понимается под проверкой?
Результаты любого математического вычисления всегда можно проверить, этому учат детей еще в начальных классах. Логично предположить, что раз статистические показатели определяются при помощи цепи вычислений, то и проверяются.
Однако проверка статистической значимости - не только математика. Статистика имеет дело с большим количеством переменных величин и различных вероятностей, далеко не всегда поддающихся расчету. То есть если вернутся к приведенному в начале статьи примеру с резиновой обувью, то логичное построение статистических данных, на которые станут опираться закупщики товаров для магазинов, может быть нарушено сухой и жаркой погодой, которая не типична для осени. В результате этого явления число людей, приобретающих резиновые сапоги, снизится, а торговые точки потерпят убытки. Предусмотреть погодную аномалию математическая формула, разумеется, не в состоянии. Этот момент называется - «ошибка».
Вот как раз вероятность таких ошибок и учитывает проверка уровня вычисленной значимости. В ней учитываются как вычисленные показатели, так и принятые уровни значимости, а также величины, условно называемые гипотезами.
Что такое уровень значимости?
Понятие «уровень» входит в основные критерии статистической значимости. Используется оно в прикладной и практической статистике. Это своего рода величина, учитывающая вероятность возможных отклонений или ошибок.
Уровень основывается на выявлении различий в готовых выборках, позволяет установить их существенность либо же, наоборот, случайность. У этого понятия есть не только цифровые значения, но и их своеобразные расшифровки. Они объясняют то, как нужно понимать значение, а сам уровень определяется сравнением результата с усредненным индексом, это и выявляет степень достоверности различий.
Таким образом, можно представить понятие уровня просто - это показатель допустимой, вероятной погрешности или же ошибки в сделанных из полученных статистических данных выводах.
Какие уровни значимости используются?
Статистическая значимость коэффициентов вероятности допущенной ошибки на практике отталкивается от трех базовых уровней.
Первым уровнем считается порог, при котором значение равно 5 %. То есть вероятность погрешности не превышает уровня значимости в 5 %. Это означает, что уверенность в безупречности и безошибочности выводов, сделанных на основе данных статистических исследований, составляет 95 %.
Вторым уровнем является порог в 1 %. Соответственно, эта цифра означает, что руководствоваться полученными при статистических расчетах данными можно с уверенностью в 99 %.
Третий уровень - 0,1 %. При таком значении вероятность наличия ошибки равна доле процента, то есть погрешности практически исключаются.
Что такое гипотеза в статистике?
Ошибки как понятие разделяются по двум направлениям, касающимся принятия или же отклонения нулевой гипотезы. Гипотеза - это понятие, за которым скрывается, согласно определению, набор иных данных или же утверждений. То есть описание вероятностного распределения чего-либо, относящегося к предмету статистического учета.
Гипотез при простых расчетах бывает две - нулевая и альтернативная. Разница между ними в том, что нулевая гипотеза берет за основу представление об отсутствии принципиальных отличий между участвующими в определении статистической значимости выборками, а альтернативная ей полностью противоположна. То есть альтернативная гипотеза основана на наличии весомой разницы в данных выборок.
Какими бывают ошибки?
Ошибки как понятие в статистике находятся в прямой зависимости от принятия за истинную той или иной гипотезы. Их можно разделить на два направления или же типа:
- первый тип обусловлен принятием нулевой гипотезы, оказавшейся неверной;
- второй - вызван следованием альтернативной.
Первый тип ошибок называется ложноположительным и встречается достаточно часто во всех сферах, где используются статистические данные. Соответственно, ошибка второго типа называется ложноотрицательной.
Для чего нужна регрессия в статистике?
Статистическая значимость регрессии в том, что с ее помощью можно установить, насколько соответствует реальности вычисленная на основе данных модель различных зависимостей; позволяет выявить достаточность или же нехватку факторов для учета и выводов.
Определяется регрессивное значение с помощью сравнения результатов с перечисленными в таблицах Фишера данными. Или же при помощи дисперсионного анализа. Важное значение показатели регрессии имеют при сложных статистических исследованиях и расчетах, в которых участвует большое количество переменных величин, случайных данных и вероятных изменений.
Статистическая достоверность имеет существенное значение в расчетной практике ФКС. Ранее было отмечено, что из одной и той же генеральной совокупности может быть избрано множество выборок:
Если они подобраны корректно, то их средние показатели и показатели генеральной совокупности незначительно отличаются друг от друга величиной ошибки репрезентативности с учетом принятой надежности;
Если они избираются из разных генеральных совокупностей, различие между ними оказывается существенным. В статистике повсеместно рассматривается сравнение выборок;
Если они отличаются несущественно, непринципиально, незначительно, т. е. фактически принадлежат одной и той же генеральной совокупности, различие между ними называется статистически недостоверным.
Статистически достоверным различием выборок называется выборка, которая различается значимо и принципиально, т. е. принадлежит разным генеральным совокупностям.
В ФКС оценка статистической достоверности различий выборок означает решение множества практических задач. Например, введение новых методик обучения, программ, комплексов упражнений, тестов, контрольных упражнений связано с их экспериментальной проверкой, которая должна показать, что испытуемая группа принципиально отлична от контрольной. Поэтому применяют специальные статистические методы, называемые критериями статистической достоверности, позволяющие обнаружить наличие или отсутствие статистически достоверного различия между выборками.
Все критерии делятся на две группы: параметрические и непараметрические. Параметрические критерии предусматривают обязательное наличие нормального закона распределения, т.е. имеется в виду обязательное определение основных показателей нормального закона - средней арифметической величины и среднего квадратического отклонения s. Параметрические критерии являются наиболее точными и корректными. Непараметрические критерии основаны на ранговых (порядковых) отличиях между элементами выборок.
Приведем основные критерии статистической достоверности, используемые в практике ФКС: критерий Стьюдента и критерий Фишера.
Критерий Стьюдента назван в честь английского ученого К. Госсета (Стьюдент - псевдоним), открывшего данный метод. Критерий Стьюдента является параметрическим, используется для сравнения абсолютных показателей выборок. Выборки могут быть различными по объему.
Критерий Стьюдента определяется так.
1. Находим критерий Стьюдента t по следующей формуле:
где - средние арифметические сравниваемых выборок; т 1 , т 2 - ошибки репрезентативности, выявленные на основании показателей сравниваемых выборок.
2. Практика в ФКС показала, что для спортивной работы достаточно принять надежность счета Р = 0,95.
Для надежности счета: Р = 0,95 (a = 0,05), при числе степеней свободы
k = n 1 + п 2 - 2 по таблице приложения 4 находим величину граничного значения критерия (t гр ).
3. На основании свойств нормального закона распределения в критерии Стьюдента осуществляется сравнение t и t гр.
Делаем выводы:
если t t гр, то различие между сравниваемыми выборками статистически достоверно;
если t t гр, то различие статистически недостоверно.
Для исследователей в области ФКС оценка статистической достоверности является первым шагом в решении конкретной задачи: принципиально или непринципиально различаются между собой сравниваемые выборки. Последующий шаг заключается в оценке этого различия с педагогической точки зрения, что определяется условием задачи.
Рассмотрим применение критерия Стьюдента на конкретном примере.
Пример 2.14. Группа испытуемых в количестве 18 человек оценена на ЧСС (уд./мин) до х i и после y i разминки.
Оценить эффективность разминки по показателю ЧСС. Исходные данные и расчеты представлены в табл. 2.30 и 2.31.
Таблица 2.30
Обработка показателей ЧСС до разминки
Ошибки по обеим группам совпали, так как объемы выборок равны (исследуется одна и та же группа при различных условиях), а средние квадратические отклонения составили s х = s у = 3 уд./мин. Переходим к определению критерия Стьюдента:
Задаем надежность счета: Р= 0,95.
Число степеней свободы k 1 = n 1 + п 2 - 2=18+18-2 = 34. По таблице приложения 4 находим t гр = 2,02.
Статистический вывод. Поскольку t = 11,62, а граничное t гр = 2,02, то 11,62 > 2,02, т.е. t > t гр, поэтому различие между выборками статистически достоверно.
Педагогический вывод. Установлено, что по показателю ЧСС различие между состоянием группы до и после разминки является статистически достоверным, т.е. значимым, принципиальным. Итак, по показателю ЧСС можно сделать вывод, что разминка эффективна.
Критерий Фишера является параметрическим. Он применяется при сравнении показателей рассеивания выборок. Это, как правило, означает сравнение по показателям стабильности спортивной работы или стабильности функциональных и технических показателей в практике физической культуры и спорта. Выборки могут быть разновеликими.
Критерий Фишера определяется в нижеприведенной последовательности.
1. Находим Критерий Фишера F по формуле
где , - дисперсии сравниваемых выборок.
Условиями критерия Фишера предусмотрено, что в числителе формулы F находится большая дисперсия, т.е. число F всегда больше единицы.
Задаем надежность счета: Р = 0,95 - и определяем числа степеней свободы для обеих выборок: k 1 = n 1 - 1 , k 2 = п 2 - 1.
По таблице приложения 4 находим граничное значение критерия F гр .
Сравнение критериев F и F гр позволяет сформулировать выводы:
если F > F гр, то различие между выборками статистически достоверно;
если F< F гр, то различие между выборками статически недостоверно.
Приведем конкретный пример.
Пример 2.15. Проанализируем две группы гандболистов: х i (n 1 = 16 человек) и y i (п 2 = 18 человек). Эти группы спортсменов исследованы на время отталкивания (с) при броске мяча в ворота.
Однотипны ли показатели отталкивания?
Исходные данные и основные расчеты представлены в табл. 2.32 и 2.33.
Таблица 2.32
Обработка показателей отталкивания первой группы гандболистов
Определим критерий Фишера:
По данным, представленным в таблице приложения 6, находим Fгр: Fгр = 2,4
Обратим внимание на то, что в таблице приложения 6 перечисление чисел степеней свободы как большей, так и меньшей дисперсии при приближении к большим числам становится грубее. Так, числа степеней свободы большей дисперсии следует в таком порядке: 8, 9, 10, 11, 12, 14, 16, 20, 24 и т.д., а меньшей - 28, 29, 30, 40, 50 и т.д.
Это объясняется тем, что при увеличении объема выборок различия F-критерия уменьшаются и можно использовать табличные значения, приближенные к исходным данным. Так, в примере 2.15 =17 отсутствует и можно принять ближайшее к нему значение k = 16, откуда и получаем Fгр = 2,4.
Статистический вывод. Поскольку критерий Фишера F= 2,5 > F= 2,4, выборки различимы статистически достоверно.
Педагогический вывод. Значения времени отталкивания (с) при броске мяча в ворота у гандболистов обеих групп существенно различаются. Эти группы следует рассматривать как различные.
Дальнейшие исследования должны показать, в чем причина такого различия.
Пример 2.20 .(на статистическую достоверность выборки ). Повысилась ли квалификация футболиста, если время (с) от подачи сигнала до удара по мячу ногой в начале тренировки было x i , а в конце у i .
Исходные данные и основные расчеты приведены в табл. 2.40 и 2.41.
Таблица 2.40
Обработка показателей времени от подачи сигнала до удара по мячу в начале тренировки
Определим различие групп показателей по критерию Стьюдента:

При надежности Р = 0,95 и степенях свободы k = n 1 + п 2 - 2 = 22 + 22 - 2 = 42 по таблице приложения 4 находим t гр = 2,02. Поскольку t = 8,3 > t гр = 2,02 - различие статистически достоверно.
Определим различие групп показателей по критерию Фишера:
 |
По таблице приложения 2 при надежности Р = 0,95 и степенях свободы k = 22-1=21 значение F гр = 21. Поскольку F= 1,53 < F гр = = 2,1, различие в рассеивании исходных данных статистически недостоверно.
Статистический вывод. По среднему арифметическому показателю различие групп показателей статистически достоверно. По показателю рассеивания (дисперсии) различие групп показателей статистически недостоверно.
Педагогический вывод. Квалификация футболиста существенно повысилась, однако следует уделить внимание стабильности его показаний.
Подготовка к работе
Перед проведением данной лабораторной работы по дисциплине «Спортивная метрология» всем студентам учебной группы необходимо сформировать рабочие бригады по 3-4 студента в каждой , для совместного выполнения рабочего задания всех лабораторных работ.
При подготовке к работе ознакомиться с соответствующими разделами рекомендуемой литературы (см.раздел 6 данных методических указаний) и конспектов лекций. Изучить разделы 1 и 2 на данную лабораторную работу, а также рабочее задание на неё (раздел 4).
Заготовить форму отчета на стандартных листах писчей бумаги формата А4 и занести в нее материалы необходимые для работы.
Отчет должен содержать :
Титульный лист с указанием кафедры (УК и ТР), учебной группы, фамилии, имени, отчества студента, номера и названия лабораторной работы, даты ее выполнения, а также фамилии, учёной степени, учёного звания и должности преподавателя, принимающего работу;
Цель работы;
Формулы с числовыми значениями, поясняющие промежуточные и окончательные результаты вычислений;
Таблицы измеренных и вычисленных величин;
Требуемый по заданию графический материал;
Краткие выводы по результатам каждого из этапов рабочего задания и в целом по выполненной работе.
Все графики и таблицы вычерчиваются аккуратно при помощи чертежных инструментов. Условные графические и буквенные обозначения должны соответствовать ГОСТам. Допускается оформление отчёта с применением вычислительной (компьютерной) техники.
Рабочее задание
Перед проведением всех измерений каждому члену бригады необходимо изучить правила использования спортивной игры Дартс, приведенные в приложении 7, которые необходимы для проведения нижеприведенных этапов исследований.
I – й этап исследований «Исследование результатов попаданий в мишень спортивной игры Дартс каждым членом бригады на соответствие нормальному закону распределения по критерию χ 2 Пирсона и критерию трёх сигм»
1. провести измерение (испытание) своей (личной) быстроты и координированности действий, путём бросания 30-40 раз дротиков в круговую мишень спортивной игры Дартс.
2. Результаты измерений (испытаний) x i (в очках) оформить в виде вариационного ряда и занести в таблицу 4.1 (столбцы , выполнить все необходимые расчёты, заполнить необходимые таблицы и сделать соответствующие выводы на соответствие полученного эмпирического распределения нормальному закону распределения, по аналогии с аналогичными расчётами, таблицами и выводами примера 2.12, приведенного в разделе 2 данных методических указаний на страницах 7 -10.
Таблица 4.1
Соответствие быстроты и координированности действий испытуемых нормальному закону распределения
| № п/п | округ- ленно | |||||||||
| … | ||||||||||
| … | ||||||||||
| Всего |
II – й этап исследований
«Оценка средних показателей генеральной совокупности попаданий в мишень спортивной игры Дартс всех студентов учебной группы по результатам измерений членов одной бригады»
Оценить средние показатели быстроты и координированности действий всех студентов учебной группы (согласно списка учебной группы классного журнала) по результатам попаданий в мишень спортивной игры Дартс всех членов бригады, полученным на первом этапе исследований данной лабораторной работы.
1. Оформить результаты измерений быстроты и координированности действий при бросании дротиков в круговую мишень спортивной игры Дартс всех членов Вашей бригады (2 – 4 человека), которые представляют собой выборку результатов измерений из генеральной совокупности (результаты измерений всех студентов учебной группы – например, 15 человек), занеся их во второй и третий столбцы таблицы 4.2.
Таблица 4.2
Обработка показателей быстроты и координированности действий
членов бригады
| № п/п | ||||||
| … | ||||||
| … | ||||||
| Всего |
В таблице 4.2 под следует понимать , совпавшее среднее количество баллов (см. результаты расчётов по таблице 4.1) членами Вашей бригады ( , полученное на первом этапе исследований. Следует заметить, что, как правило, в таблице 4.2 есть рассчитанное среднее значение результатов измерений полученное одним членом бригады на первом этапе исследований , так как вероятность, того что результаты измерений различными членами бригады совпадут очень мала. Тогда, как правило, значения в столбце таблицы 4.2 для каждой из строк - равны 1, а в строке «Всего » графы « », записывается число членов Вашей бригады.
2. Выполнить все необходимые расчёты по заполнению таблицы 4.2, а также другие расчёты и выводы, аналогичные расчётам и выводам примера 2.13, приведенным в 2-ом разделе данной методической разработки на страницах 13-14. Следует иметь ввиду, при расчёте ошибки репрезентативности «m» необходимо использовать формулу 2.4, приведенную на странице 13 данной методической разработки, так как выборка мала (n , а число элементов генеральной совокупности N известно, и равно числу студентов учебной группы, согласно списка журнала учебной группы.
III – й этап исследований
Оценка эффективности разминки по показателю «Быстрота и координированность действий» каждым членом бригады с помощью критерия Стьюдента
Оценить эффективность разминки по бросанию дротиков в мишень спортивной игры «Дартс», выполненную на первом этапе исследований данной лабораторной работы, каждым членом бригады по показателю «Быстрота и координированность действий», с помощью критерия Стьюдента - параметрического критерия статистической достоверности эмпирического закона распределения нормальному закону распределения.
2. дисперсии и СКО , результатов измерений показателя «Быстрота и координированность действий» по результатам разминки, приведенных в таблице 4.3, (см. аналогичные расчёты приведенные сразу после таблицы 2.30 примера 2.14 на странице 16 данной методической разработки).
3. Каждому члену рабочей бригады провести измерение (испытание) своей (личной) быстроты и координированности действий после разминки,
5. Произвести вычисления среднего значения дисперсии и СКО , результатов измерений показателя «Быстрота и координированность действий» после разминки, приведенных в таблице 4.4, записать в целом результат измерений по результатам разминки (см. аналогичные расчеты, приведенные сразу после таблицы 2.31 примера 2.14 на странице 17 данной методической разработки).
6. Выполнить все необходимые расчёты и выводы, аналогичные расчётам и выводам примера 2.14, приведенным в 2-ом разделе данной методической разработки на страницах 16-17. Следует иметь ввиду, при расчёте ошибки репрезентативности «m» необходимо использовать формулу 2.1, приведенную на странице 12 данной методической разработки, так как выборка n , а число элементов генеральной совокупности N ( неизвестно.
IV – й этап исследований
Оценка однотипности (стабильности) показателей «Быстрота и координированность действий» двух членов бригады с помощью критерия Фишера
Оценить однотипность (стабильность) показателей «Быстрота и координированность действий» двух членов бригады с помощью критерия Фишера, по результатам измерений, полученным на третьем этапе исследований данной лабораторной работы.
Для этого необходимо выполнить следующее.
Используя данные таблиц 4.3 и 4.4, результаты расчётов дисперсий по этим таблицам , полученные на третьем этапе исследований, а также методику расчёта и применения критерия Фишера для оценки однотипности (стабильности) спортивных показателей, приведенную в примере 2.15 на страницах 18-19 данной методической разработки, сделать соответствующие статистический и педагогический выводы.
V – й этап исследований
Оценка групп показателей «Быстрота и координированность действий» одного члена бригады до и после разминки
Основные черты всякой зависимости между переменными.
Можно отметить два самых простых свойства зависимости между переменными: (a) величина зависимости и (b) надежность зависимости.
- Величина . Величину зависимости легче понять и измерить, чем надежность. Например, если любой мужчина в выборке имел значение числа лейкоцитов (WCC) выше чем любая женщина, то вы можете сказать, что зависимость между двумя переменными (Пол и WCC) очень высокая. Другими словами, вы могли бы предсказать значения одной переменной по значениям другой.
- Надежность ("истинность"). Надежность взаимозависимости - менее наглядное понятие, чем величина зависимости, однако чрезвычайно важное. Надежность зависимости непосредственно связана с репрезентативностью определенной выборки, на основе которой строятся выводы. Другими словами, надежность говорит о том, насколько вероятно, что зависимость будет вновь обнаружена (иными словами, подтвердится) на данных другой выборки, извлеченной из той же самой популяции.
Следует помнить, что конечной целью почти никогда не является изучение данной конкретной выборки значений; выборка представляет интерес лишь постольку, поскольку она дает информацию обо всей популяции. Если исследование удовлетворяет некоторым специальным критериям, то надежность найденных зависимостей между переменными выборки можно количественно оценить и представить с помощью стандартной статистической меры.
Величина зависимости и надежность представляют две различные характеристики зависимостей между переменными. Тем не менее, нельзя сказать, что они совершенно независимы. Чем больше величина зависимости (связи) между переменными в выборке обычного объема, тем более она надежна (см. следующий раздел).
Статистическая значимость результата (p-уровень) представляет собой оцененную меру уверенности в его "истинности" (в смысле "репрезентативности выборки"). Выражаясь более технически, p-уровень – это показатель, находящийся в убывающей зависимости от надежности результата. Более высокий p-уровень соответствует более низкому уровню доверия к найденной в выборке зависимости между переменными. Именно, p-уровень представляет собой вероятность ошибки, связанной с распространением наблюдаемого результата на всю популяцию.
Например, p-уровень = 0.05 (т.е. 1/20) показывает, что имеется 5% вероятность, что найденная в выборке связь между переменными является лишь случайной особенностью данной выборки. Во многих исследованиях p-уровень 0.05 рассматривается как "приемлемая граница" уровня ошибки.
Не существует никакого способа избежать произвола при принятии решения о том, какой уровень значимости следует действительно считать "значимым". Выбор определенного уровня значимости, выше которого результаты отвергаются как ложные, является достаточно произвольным.
На практике окончательное решение обычно зависит от того, был ли результат предсказан априори (т.е. до проведения опыта) или обнаружен апостериорно в результате многих анализов и сравнений, выполненных с множеством данных, а также на традиции, имеющейся в данной области исследований.
Обычно во многих областях результат p .05 является приемлемой границей статистической значимости, однако следует помнить, что этот уровень все еще включает довольно большую вероятность ошибки (5%).
Результаты, значимые на уровне p .01 обычно рассматриваются как статистически значимые, а результаты с уровнем p .005 или p . 001 как высоко значимые. Однако следует понимать, что данная классификация уровней значимости достаточно произвольна и является всего лишь неформальным соглашением, принятым на основе практического опыта в той или иной области исследования .
Понятно, что чем большее число анализов будет проведено с совокупностью собранных данных, тем большее число значимых (на выбранном уровне) результатов будет обнаружено чисто случайно.
Некоторые статистические методы, включающие много сравнений, и, таким образом, имеющие значительный шанс повторить такого рода ошибки, производят специальную корректировку или поправку на общее число сравнений. Тем не менее, многие статистические методы (особенно простые методы разведочного анализа данных) не предлагают какого-либо способа решения данной проблемы.
Если связь между переменными "объективно" слабая, то не существует иного способа проверить такую зависимость кроме как исследовать выборку большого объема. Даже если выборка совершенно репрезентативна, эффект не будет статистически значимым, если выборка мала. Аналогично, если зависимость "объективно" очень сильная, тогда она может быть обнаружена с высокой степенью значимости даже на очень маленькой выборке.
Чем слабее зависимость между переменными, тем большего объема требуется выборка, чтобы значимо ее обнаружить.
Разработано много различных мер взаимосвязи между переменными. Выбор определенной меры в конкретном исследовании зависит от числа переменных, используемых шкал измерения, природы зависимостей и т.д.
Большинство этих мер, тем не менее, подчиняются общему принципу: они пытаются оценить наблюдаемую зависимость, сравнивая ее с "максимальной мыслимой зависимостью" между рассматриваемыми переменными. Говоря технически, обычный способ выполнить такие оценки заключается в том, чтобы посмотреть, как варьируются значения переменных и затем подсчитать, какую часть всей имеющейся вариации можно объяснить наличием "общей" ("совместной") вариации двух (или более) переменных.
Значимость зависит в основном от объема выборки. Как уже объяснялось, в очень больших выборках даже очень слабые зависимости между переменными будут значимыми, в то время как в малых выборках даже очень сильные зависимости не являются надежными.
Таким образом, для того чтобы определить уровень статистической значимости, нужна функция, которая представляла бы зависимость между "величиной" и "значимостью" зависимости между переменными для каждого объема выборки.
Такая функция указала бы точно "насколько вероятно получить зависимость данной величины (или больше) в выборке данного объема, в предположении, что в популяции такой зависимости нет". Другими словами, эта функция давала бы уровень значимости
(p -уровень), и, следовательно, вероятность ошибочно отклонить предположение об отсутствии данной зависимости в популяции.
Эта "альтернативная" гипотеза (состоящая в том, что нет зависимости в популяции) обычно называется нулевой гипотезой .
Было бы идеально, если бы функция, вычисляющая вероятность ошибки, была линейной и имела только различные наклоны для разных объемов выборки. К сожалению, эта функция существенно более сложная и не всегда точно одна и та же. Тем не менее, в большинстве случаев ее форма известна, и ее можно использовать для определения уровней значимости при исследовании выборок заданного размера. Большинство этих функций связано с классом распределений, называемым нормальным .
Исследование обычно начинается с некоторого предположения, требую-щего проверки с привлечением фактов. Это предположение — гипотеза — формулируется в отношении связи явлений или свойств в некоторой сово-купности объектов.
Для проверки подобных предположений на фактах необходимо измерить соответствующие свойства у их носителей. Но невозможно измерить тревож-ность у всех женщин и мужчин, как невозможно измерить агрессивность у всех подростков. Поэтому при проведении исследования ограничиваются лишь относительно небольшой группой представителей соответствующих совокупностей людей.
Генеральная совокупность — это все множество объектов, в отношении ко-торого формулируется исследовательская гипотеза.
Например, все мужчины; или все женщины; или все жители какого-либо города. Генеральные совокупности, в отно-шении которых исследователь собирается сделать выводы по результатам ис-следования, могут быть по численности и более скромными, например, все первоклассники данной школы.
Таким образом, генеральная совокупность — это хотя и не бесконечное по численности, но, как правило, недоступное для сплошного исследования мно-жество потенциальных испытуемых.
Выборка или выборочная совокупность — это ограниченная по численности группа объектов (в психоло-гии — испытуемых, респондентов), специально отбираемая из генеральной совокупности для изучения ее свойств. Соответственно, изучение на выбор-ке свойств генеральной совокупности называется выборочным исследованием. Практически все психологические исследования являются выборочными, а их выводы распространяются на генеральные совокупности.
Таким образом, после того, как сформулирована гипотеза и определены соответствующие генеральные совокупности, перед исследователем возни-кает проблема организации выборки. Выборка должна быть такой, чтобы была обоснована генерализация выводов выборочного исследования — обобщение, распространение их на генеральную совокупность. Основные критерии обо-снованности выводов исследования — это репрезентативность выборки и ста-тистическая достоверность (эмпирических) результатов.
Репрезентативность выборки — иными словами, ее представительность — это способность выборки представлять изучаемые явления достаточно пол-но — с точки зрения их изменчивости в генеральной совокупности.
Конечно, полное представление об изучаемом явлении, во всем его диапа-зоне и нюансах изменчивости, может дать только генеральная совокупность. Поэтому репрезентативность всегда ограничена в той мере, в какой ограни-чена выборка. И именно репрезентативность выборки является основным кри-терием при определении границ генерализации выводов исследования. Тем не менее, существуют приемы, позволяющие получить достаточную для ис-следователя репрезентативность выборки (Эти приемы изучаются в курсе «Экспериментальная психология»).
Первый и основной прием — это простой случайный (рандомизированный) отбор. Он предполагает обеспечение таких условий, чтобы каждый член генеральной совокупности имел равные с другими шансы попасть в выборку. Слу-чайный отбор обеспечивает возможность попадания в выборку самых разных представителей генеральной совокупности. При этом принимаются специ-альные меры, исключающие появление какой-либо закономерности при отборе. И это позволяет надеяться на то, что в конечном итоге в выборке изу-чаемое свойство будет представлено если и не во всем, то в максимально воз-можном его многообразии.
Второй способ обеспечения репрезентативности — это стратифицирован-ный случайный отбор, или отбор по свойствам генеральной совокупности. Он предполагает предварительное определение тех качеств, которые могут вли-ять на изменчивость изучаемого свойства (это может быть пол, уровень дохо-да или образования и т. д.). Затем определяется процентное соотношение чис-ленности различающихся по этих качествам групп (страт) в генеральной совокупности и обеспечивается идентичное процентное соотношение соот-ветствующих групп в выборке. Далее в каждую подгруппу выборки испытуе-мые подбираются по принципу простого случайного отбора.
Статистическая достоверность , или статистическая значимость, результа-тов исследования определяется при помощи методов статистического выво-да.
Застрахованы ли мы от принятия ошибок при принятии решений, при тех или иных выводах из результатов исследования? Конечно, нет. Ведь наши решения опираются на результаты исследования выборочной совокупности, а также на уровень наших психологических знаний. Полностью мы не застрахованы от ошибок. В статистике такие ошибки считаются допустимыми, если они имеют место не чаще чем в одном случае из 1000 (вероятность ошибки α=0,001 или сопряженная с этим величина доверительная вероятность правильного вывода р=0,999); в одном случае из 100 (вероятность ошибки α=0,01 или сопряженная с этим величина доверительная вероятность правильного вывода р=0,99) или в пяти случаях из 100 (вероятность ошибки α=0,05 или сопряженная с этим величина доверительная вероятность правильного вывода р=0,95). Именно на двух последних уровнях и принято принимать решения в психологии.
Иногда, говоря о статистической достоверности, используют понятие «уровень значимости» (обозначается как α). Численные значения р и α дополняют друг друга до 1,000 — полный набор событий: либо мы сделали правильный вывод, либо мы ошиблись. Эти уровни не рассчитываются, они заданы. Уровень значимости можно понимать как некую «красную» линию», пересечение которой позволит говорить о данном событии как о неслучайном. В каждом грамотном научном отчете или публикации сделанные выводы должны сопровождаться указанием значений р или α, при которых сделаны выводы.
Методы статистического вывода подробно рассматриваются в курсе «Математической статистики». Сейчас лишь отметим, что они предъявляют определенные требования к численности, или объему выборки.
К сожалению, строгих рекомендаций по предварительному определению требуемого объема выборки не существует. Более того, ответ на вопрос о не-обходимой и достаточной ее численности исследователь обычно получает слишком поздно — только после анализа данных уже обследованной выбор-ки. Тем не менее, можно сформулировать наиболее общие рекомендации:
1. Наибольший объем выборки необходим при разработке диагностичес-кой методики — от 200 до 1000-2500 человек.
2. Если необходимо сравнивать 2 выборки, их общая численность должна быть не менее 50 человек; численность сравниваемых выборок должна быть приблизительно одинаковой.
3. Если изучается взаимосвязь между какими-либо свойствами, то объем выборки должен быть не меньше 30-35 человек.
4. Чем больше изменчивость изучаемого свойства , тем больше должен быть объем выборки. Поэтому изменчивость можно уменьшить, увеличивая однородность выборки, например, по полу, возрасту и т. д. При этом, естественно, уменьшаются возможности генерализации выводов.
Зависимые и независимые выборки. Обычна ситуация исследования, когда интересующее исследователя свойство изучается на двух или более выборках с целью их дальнейшего сравнения. Эти выборки могут находиться в различ-ных соотношениях — в зависимости от процедуры их организации. Независи-мые выборки характеризуются тем, что вероятность отбора любого испытуе-мого одной выборки не зависит от отбора любого из испытуемых другой выборки. Напротив, зависимые выборки характеризуются тем, что каждому испытуемому одной выборки поставлен в соответствие по определенному критерию испытуемый из другой выборки.
В общем случае зависимые выборки предполагают попарный подбор ис-пытуемых в сравниваемые выборки, а независимые выборки — независимый отбор испытуемых.
Следует отметить, что случаи «частично зависимых» (или «частично неза-висимых») выборок недопустимы: это непредсказуемым образом нарушает их репрезентативность.
В заключение отметим, что можно выделить две парадигмы психологи-ческого исследования.
Так называемая R-методология предполагает изучение изменчивости некоторого свойства (психологического) под влиянием неко-торого воздействия, фактора либо другого свойства. Выборкой является мно-жество испытуемых.
Другой подход, Q-методология, предполагает исследо-вание изменчивости субъекта (единичного) под влиянием различных стимулов (условий, ситуаций и т. д.). Ей соответствует ситуация, когда выборкой явля-ется множество стимулов.
Как вы думаете, что делает вашу «вторую половинку» особенной, значимой? Это связано с ее (его) личностью или с вашими чувствами, которые вы испытываете к этому человеку? А может, с простым фактом, что гипотеза о случайности вашей симпатии, как показывают исследования, имеет вероятность менее 5%? Если считать последнее утверждение достоверным, то успешных сайтов знакомств не существовало бы в принципе:
Когда вы проводите сплит-тестирование или любой другой анализ вашего сайта, неверное понимание «статистической значимости» может привести к неправильной интерпретации результатов и, следовательно, ошибочным действиям в процессе оптимизации конверсии. Это справедливо и для тысяч других статистических тестов, проводимых ежедневно в любой существующей отрасли.
Чтобы разобраться, что же такое «статистическая значимость», необходимо погрузиться в историю появления этого термина, познать его истинный смысл и понять, как это «новое» старое понимание поможет вам верно трактовать результаты своих исследований.
Немного истории
Хотя человечество использует статистику для решения тех или иных задач уже много веков, современное понимание статистической значимости, проверки гипотез, рандомизации и даже дизайна экспериментов (Design of Experiments (DOE) начало формироваться только в начале 20-го столетия и неразрывно связано с именем сэра Рональда Фишера (Sir Ronald Fisher, 1890-1962):

Рональд Фишер был эволюционным биологом и статистиком, который имел особую страсть к изучению эволюции и естественного отбора в животном и растительном мире. В течение своей прославленной карьеры он разработал и популяризировал множество полезных статистических инструментов, которыми мы пользуемся до сих пор.
Фишер использовал разработанные им методики, чтобы объяснить такие процессы в биологии, как доминирование, мутации и генетические отклонения. Те же инструменты мы можем применить сегодня для оптимизации и улучшения контента веб-ресурсов. Тот факт, что эти средства анализа могут быть задействованы для работы с предметами, которых на момент их создания даже не существовало, кажется довольно удивительным. Столь же удивительно, что раньше сложнейшие вычисления люди выполняли без калькуляторов или компьютеров.
Для описания результатов статистического эксперимента как имеющих высокую вероятность оказаться истиной Фишер использовал слово «значимость» (от англ. significance).
Также одной из наиболее интересных разработок Фишера можно назвать гипотезу «сексуального сына». Согласно этой теории, женщины отдают свое предпочтение неразборчивым в половых связях мужчинам (гулящим), потому что это позволит рожденным от этих мужчин сыновьям иметь такую же предрасположенность и произвести на свет больше своих отпрысков (обращаем внимание, что это всего лишь теория).
Но никто, даже гениальные ученые, не застрахованы от совершения ошибок. Огрехи Фишера досаждают специалистам и по сей день. Но помните слова Альберта Эйнштейна: «Кто никогда не ошибался, тот не создавал ничего нового».
Прежде чем перейти к следующему пункту, запомните: статистическая значимость — это ситуация, когда разница в результатах при проведении тестирования настолько велика, что эту разницу нельзя объяснить влиянием случайных факторов.
Какова ваша гипотеза?
Чтобы понять, что значит «статистическая значимость», сначала нужно разобраться с тем, что такое «проверка гипотез», поскольку два этих термина тесно переплетаются.
Гипотеза — это всего лишь теория. Как только вы разработаете какую-либо теорию, вам будет необходимо установить порядок сбора достаточного количества доказательств и, собственно, собрать эти доказательства. Существует два типа гипотез.
Яблоки или апельсины — что лучше?
Нулевая гипотеза
Как правило, именно в этом месте многие испытывают трудности. Нужно иметь в виду, что нулевая гипотеза — это не то, что нужно доказать, как, например, вы доказываете, что определенное изменение на сайте приведет к повышению конверсии, а наоборот. Нулевая гипотеза — это теория, которая гласит, что при внесении каких-либо изменений на сайт ничего не произойдет. И цель исследователя — опровергнуть эту теорию, а не доказать.
Если обратиться к опыту раскрытия преступлений, где следователи также строят гипотезы в отношении того, кто является преступником, нулевая гипотеза принимает вид так называемой презумпции невиновности, концепта, согласно которому обвиняемый считается невиновным до тех пор, пока его вина не будет доказана в суде.
Если нулевая гипотеза заключается в том, что два объекта равны в своих свойствах, а вы пытаетесь доказать, что один из них все же лучше (например, A лучше B), вам нужно отказаться от нулевой гипотезы в пользу альтернативной. Например, вы сравниваете между собой тот или иной инструмент для оптимизации конверсии. В нулевой гипотезе они оба оказывают на объект воздействия одинаковый эффект (или не оказывают никакого эффекта). В альтернативной — эффект от одного из них лучше.
Ваша альтернативная гипотеза может содержать числовое значение, например, B - A > 20%. В таком случае нулевая гипотеза и альтернативная могут принять следующий вид:
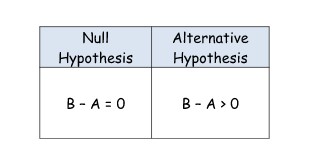
Другое название для альтернативной гипотезы — это исследовательская гипотеза, поскольку исследователь всегда заинтересован в доказательстве именно этой гипотезы.
Статистическая значимость и значение «p»
Вновь вернемся к Рональду Фишеру и его понятию о статистической значимости.
Теперь, когда у вас есть нулевая гипотеза и альтернативная, как вы можете доказать одно и опровергнуть другое?
Поскольку статистические данные по самой своей природе предполагают изучение определенной совокупности (выборки), вы никогда не можете быть на 100% уверены в полученных результатах. Наглядный пример: зачастую результаты выборов расходятся с результатами предварительных опросов и даже эксит-пулов.
Доктор Фишер хотел создать определитель (dividing line), который позволял бы понять, удался ли ваш эксперимент или нет. Так и появился индекс достоверности. Достоверность — это тот уровень, который мы принимаем для того, чтобы сказать, что мы считаем «значимым», а что нет. Если «p», индекс достоверности, равен 0,05 или меньше, то результаты достоверны.
Не волнуйтесь, в действительности все не так запутано, как кажется.
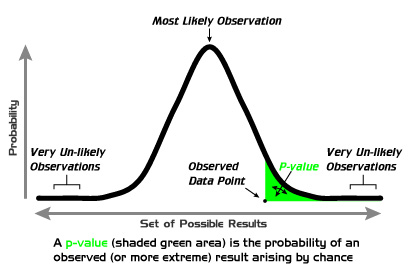
Распределение вероятностей Гаусса. По краям — менее вероятные значения переменной, в центре — наиболее вероятные. P-показатель (закрашенная зеленым область) — это вероятность наблюдаемого результата, возникающего случайно.
Нормальное распределение вероятностей (распределение Гаусса) — это представление всех возможных значений некой переменной на графике (на рисунке выше) и их частот. Если вы проведете свое исследование правильно, а затем расположите все полученные ответы на графике, вы получите именно такое распределение. Согласно нормальному распределению, вы получите большой процент похожих ответов, а оставшиеся варианты разместятся по краям графика (так называемые «хвосты»). Такое распределение величин часто встречается в природе, поэтому оно и носит название «нормального».
Используя уравнение на основе вашей выборки и результатов теста, вы можете вычислить то, что называется «тестовой статистикой», которая укажет, насколько отклонились полученные результаты. Она также подскажет, насколько близко вы к тому, чтобы нулевая гипотеза оказалась верной.
Чтобы не забивать свою голову, используйте онлайн-калькуляторы для вычисления статистической значимости:
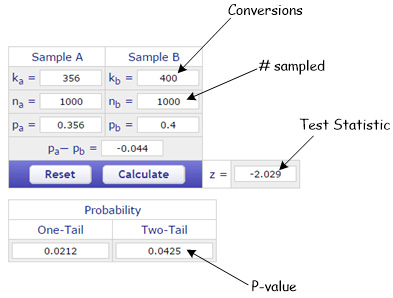
Один из примеров таких калькуляторов
Буква «p» обозначает вероятность того, что нулевая гипотеза верна. Если число будет небольшим, это укажет на разницу между тестовыми группами, тогда как нулевая гипотеза будет заключаться в том, что они одинаковы. Графически это будет выглядеть так, что ваша тестовая статистика окажется ближе к одному из хвостов вашего колоколообразного распределения.
Доктор Фишер решил установить порог достоверности результатов на уровне p ≤ 0,05. Однако и это утверждение спорное, поскольку приводит к двум затруднениям:
1. Во-первых, тот факт, что вы доказали несостоятельность нулевой гипотезы, не означает, что вы доказали альтернативную гипотезу. Вся эта значимость всего лишь значит, что вы не можете доказать ни A, ни B.
2. Во-вторых, если p-показатель будет равен 0,049, это будет означать, что вероятность нулевой гипотезы составит 4,9%. Это может означать, что в одно и то же время результаты ваших тестов могут быть одновременно и достоверными, и ошибочными.
Вы можете использовать p-показатель, а можете отказаться от него, но тогда вам будет необходимо в каждом отдельном случае высчитывать вероятность осуществления нулевой гипотезы и решать, достаточно ли она большая, чтобы не вносить тех изменений, которые вы планировали и тестировали.
Наиболее распространенный сценарий проведения статистического теста сегодня — это установление порога значимости p ≤ 0,05 до запуска самого теста. Только не забудьте внимательно изучить p-значение при проверке результатов.
Ошибки 1 и 2
Прошло так много времени, что ошибки, которые могут возникнуть при использовании показателя статистической значимости, даже получили собственные имена.
Ошибка 1 (Type 1 Errors)
Как было упомянуто выше, p-значение, равное 0,05, означает: вероятность того, что нулевая гипотеза окажется верной, равняется 5%. Если вы откажетесь от нее, вы совершите ошибку под номером 1. Результаты говорят, что ваш новый веб-сайт повысил показатели конверсии, но существует 5%-ная вероятность, что это не так.
Ошибка 2 (Type 2 Errors)
Эта ошибка является противоположной ошибке 1: вы принимаете нулевую гипотезу, в то время как она является ложной. К примеру, результаты тестов говорят вам, что внесенные изменения в сайт не принесли никаких улучшений, тогда как изменения были. Как итог: вы упускаете возможность повысить свои показатели.
Такая ошибка распространена в тестах с недостаточным размером выборки, поэтому помните: чем больше выборка, тем достовернее результат.
Заключение
Пожалуй, ни один термин среди исследователей не пользуется такой популярностью, как статистическая значимость. Когда результаты тестов не признаются статистически значимыми, последствия бывают самые разные: от роста показателя конверсии до краха компании.
И раз уж маркетологи используют этот термин при оптимизации своих ресурсов, нужно знать, что же он означает на самом деле. Условия проведения тестов могут меняться, но размер выборки и критерий успеха важен всегда. Помните об этом.


